La IA aplicada falla cuando acelera el proceso equivocado
La IA aplicada no genera impacto por acelerar tareas aisladas. Juan Pablo Ingrassia explica por qué el valor aparece al rediseñar workflows completos, medir resultados y decidir qué resuelve código, un agente o una persona.
Por Juan Pablo Ingrassia, VP Applied AI & Forward-Deployed Engineering en Santex
Hay una escena que se repite en casi todas las conversaciones de IA empresarial.
Alguien muestra un copilot que redacta un mail, resume una reunión o encuentra una respuesta en un documento. El equipo se entusiasma, la empresa compra licencias y organiza capacitaciones, y unos meses después sigue esperando aprobaciones, persiguiendo datos, copiando información entre sistemas y descubriendo riesgos demasiado tarde.
La herramienta puede ser buena. El problema es que quedó pegada a una tarea aislada mientras el proceso alrededor siguió igual.
Michael Hammer lo formuló hace más de tres décadas: informatizar el modo viejo de trabajar no arregla el modo viejo de trabajar. Con IA pasa exactamente lo mismo, solo que ahora la velocidad de la demo nos hace confundir actividad con impacto.
Construyendo STX Agents, esa diferencia se volvió muy concreta. Un agente puede preparar un brief excelente y no cambiar nada si la persona que debía actuar nunca lo ve, si la información crítica está en tres sistemas que no conversan o si nadie definió quién toma la decisión cuando aparece una excepción. Por eso la unidad de valor es el workflow completo, y no el agente.
El problema está entre los sistemas
Las empresas ya tienen sistemas para registrar lo que pasa: CRM, ERP, ticketing, documentos, mail, planillas, canales de chat. El trabajo que más tiempo consume suele vivir entre ellos.
Ahí es donde alguien junta contexto para una reunión, persigue un dato faltante, interpreta una excepción, vuelve a cargar información o detecta tarde que un proyecto cambió de riesgo. Nada de eso aparece como una tarea formal en un sistema, pero ahí se va una parte enorme de la capacidad de los equipos.
Antes de hablar de agentes, hay que ubicar el cuello de botella y la decisión que hoy llega tarde por ese cuello de botella.
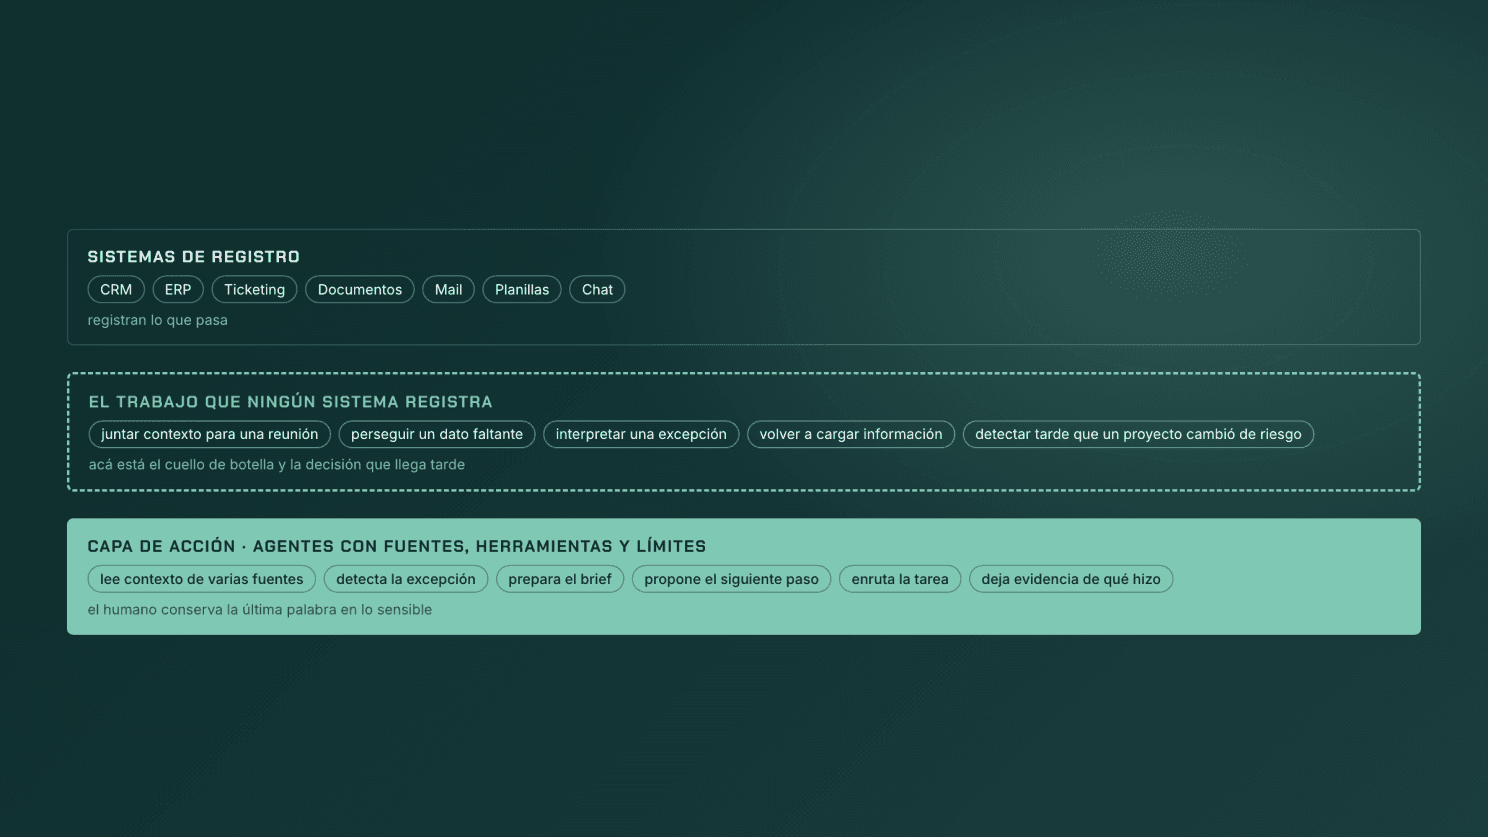
El problema vive entre los sistemas.
En Santex, el problema rara vez es que alguien tarde demasiado en hacer una tarea. Aparece cuando una señal queda repartida entre una conversación de Slack, una reunión, un documento y el sistema donde debería convertirse en acción.
Un riesgo de delivery puede haber surgido en una llamada. La persona que podría destrabarlo se entera recién en la revisión semanal, cuando cinco personas ya reconstruyeron el contexto. Una señal comercial puede estar en una conversación y llegar a Sales cuando la ventana ya pasó. El trabajo manual, más que redactar el update, es volver a armar la historia completa cada vez que alguien necesita decidir.
Ahí conviene mirar el tiempo entre señal y decisión: desde que algo cambia en la operación hasta que la persona indicada tiene evidencia suficiente para actuar. Un agente puede escribir el brief en cinco minutos; el valor aparece cuando ese brief conecta la señal correcta, el dueño correcto y el próximo paso a tiempo.
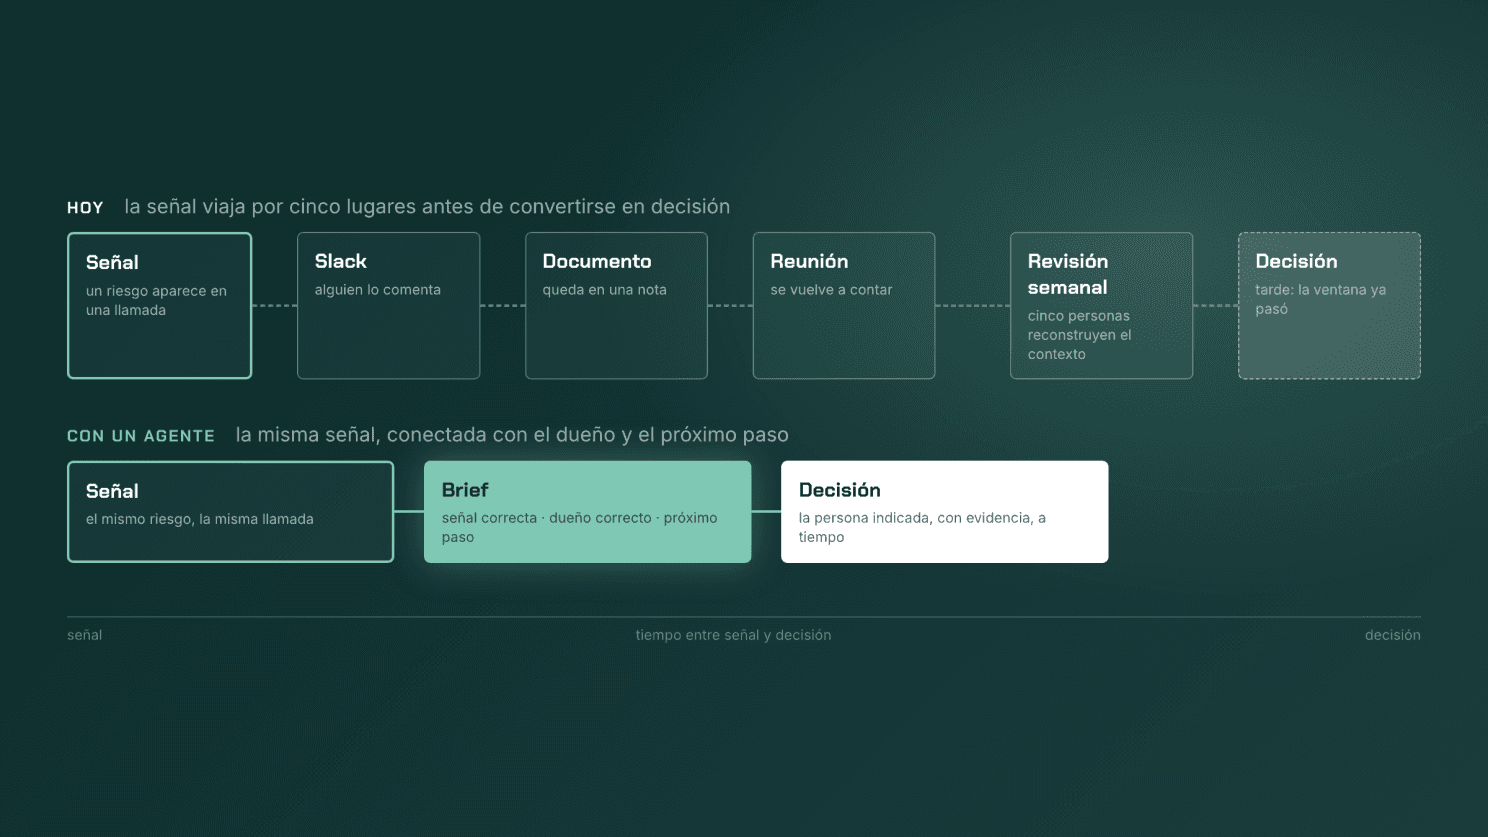
Tiempo entre señal y decisión.
La señal de alarma: satisfacción individual sin resultado operativo
Las herramientas horizontales pueden ahorrar tiempo y hacer el trabajo individual más llevadero, pero ese ahorro no se traduce solo en productividad de la organización.
El Department for Business and Trade del Reino Unido evaluó un piloto de 1.000 licencias de Microsoft 365 Copilot. El 72% de quienes respondieron estaba satisfecho o muy satisfecho. A la vez, el informe encontró ahorros de tiempo pequeños en la mayoría de los casos y no halló evidencia de que esos ahorros ya hubieran mejorado la productividad del área.
Esa distancia entre “me gusta usarlo” y “el proceso mejoró” debería cambiar la forma en que medimos IA aplicada.
El uso de la herramienta importa poco si no podemos mostrar qué cambió en costo, tiempo de ciclo, calidad, riesgo o ingresos.
McKinsey llegó a una conclusión parecida en su encuesta global: entre 25 atributos analizados, el rediseño de workflows fue el que más se asoció con impacto en EBIT atribuible a GenAI; aun así, solo 21% de las organizaciones que usan GenAI reportó haber rediseñado al menos algunos procesos.
La adopción llegó antes que la capacidad de rediseñar el trabajo.
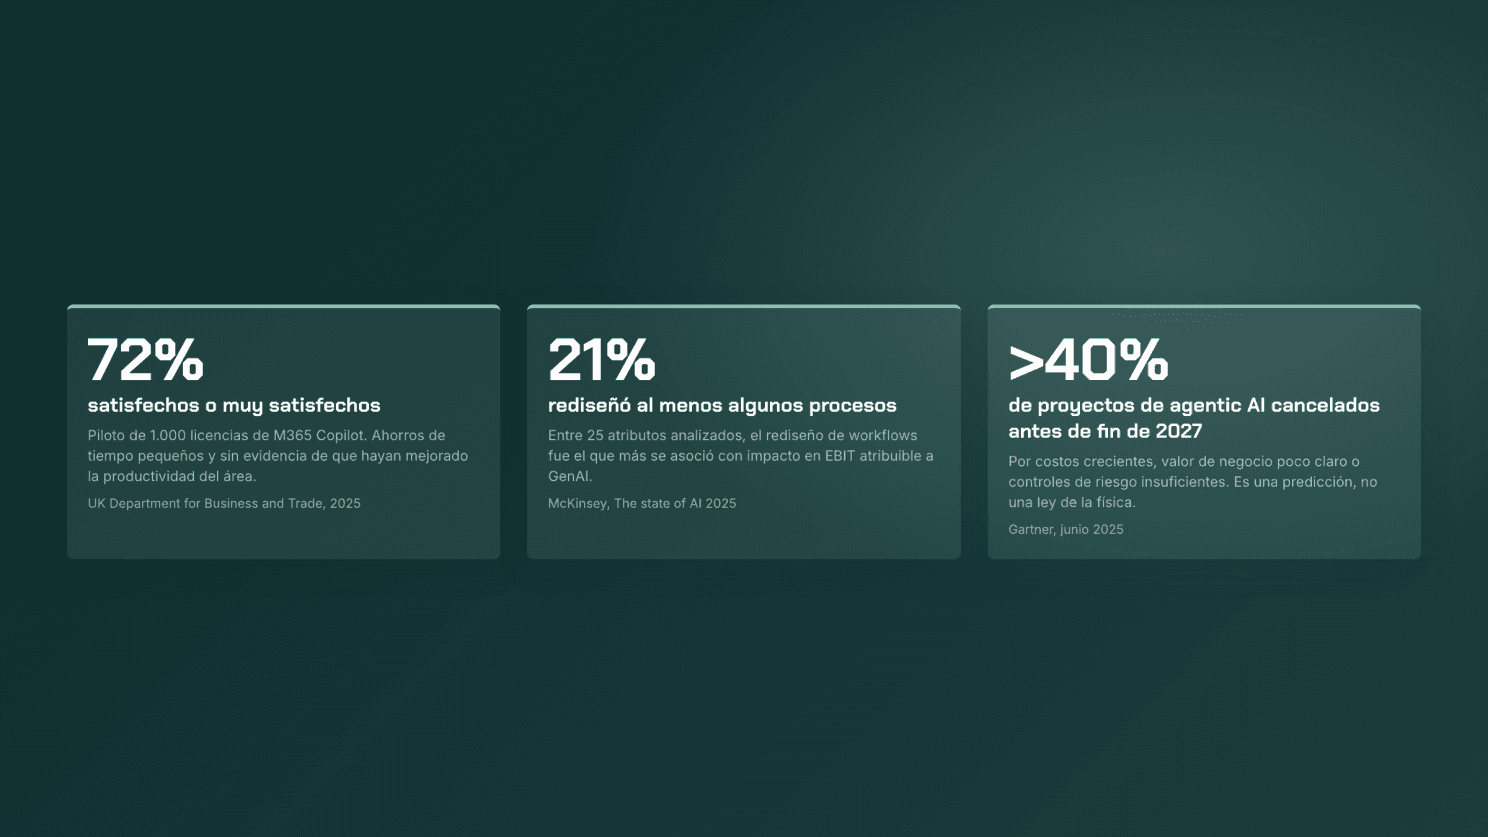
Satisfacción individual sin resultado operativo.
Lo que aprendimos construyendo agentes
1. El proceso real vive en las excepciones
Los diagramas de procesos suelen mostrar un happy path impecable. La operación real está en lo que no entra en ese dibujo: el documento con formato raro, el dato que no coincide, el cliente que cambia una condición, la persona que sabe una regla porque la vio fallar veinte veces.
Si no entendés esas excepciones, un agente funciona en la demo y se vuelve frágil apenas toca producción.
Por eso el discovery serio no empieza con “qué agente quieren”. Empieza mirando casos reales, entendiendo qué fuentes intervienen, qué se considera un buen resultado, dónde se frena el caso y quién resuelve cuando no hay una regla clara.
Las entrevistas son indispensables, pero tampoco alcanzan solas. El sistema muestra timestamps, cambios de estado, volumen y demoras. Los operadores explican por qué pasó y qué control informal evita un problema. Una fuente sin la otra deja una mitad ciega.
2. Código, agente y humano resuelven problemas distintos
La tentación más cara es usar un LLM para todo porque puede hablar bien de todo.
Una regla estable, con datos predecibles y bajo margen de interpretación, merece código común, validaciones y trazabilidad. Es más barato, más rápido y más fácil de auditar.
Un agente aporta cuando hay que leer información desordenada, cruzar contexto, clasificar casos, buscar evidencia o preparar una recomendación. Ahí el juicio es repetible, pero no cabe completo en una regla fija.
Las decisiones que mueven dinero, comprometen compliance, afectan una relación sensible o tienen evidencia insuficiente, necesitan una persona que responda por el resultado.
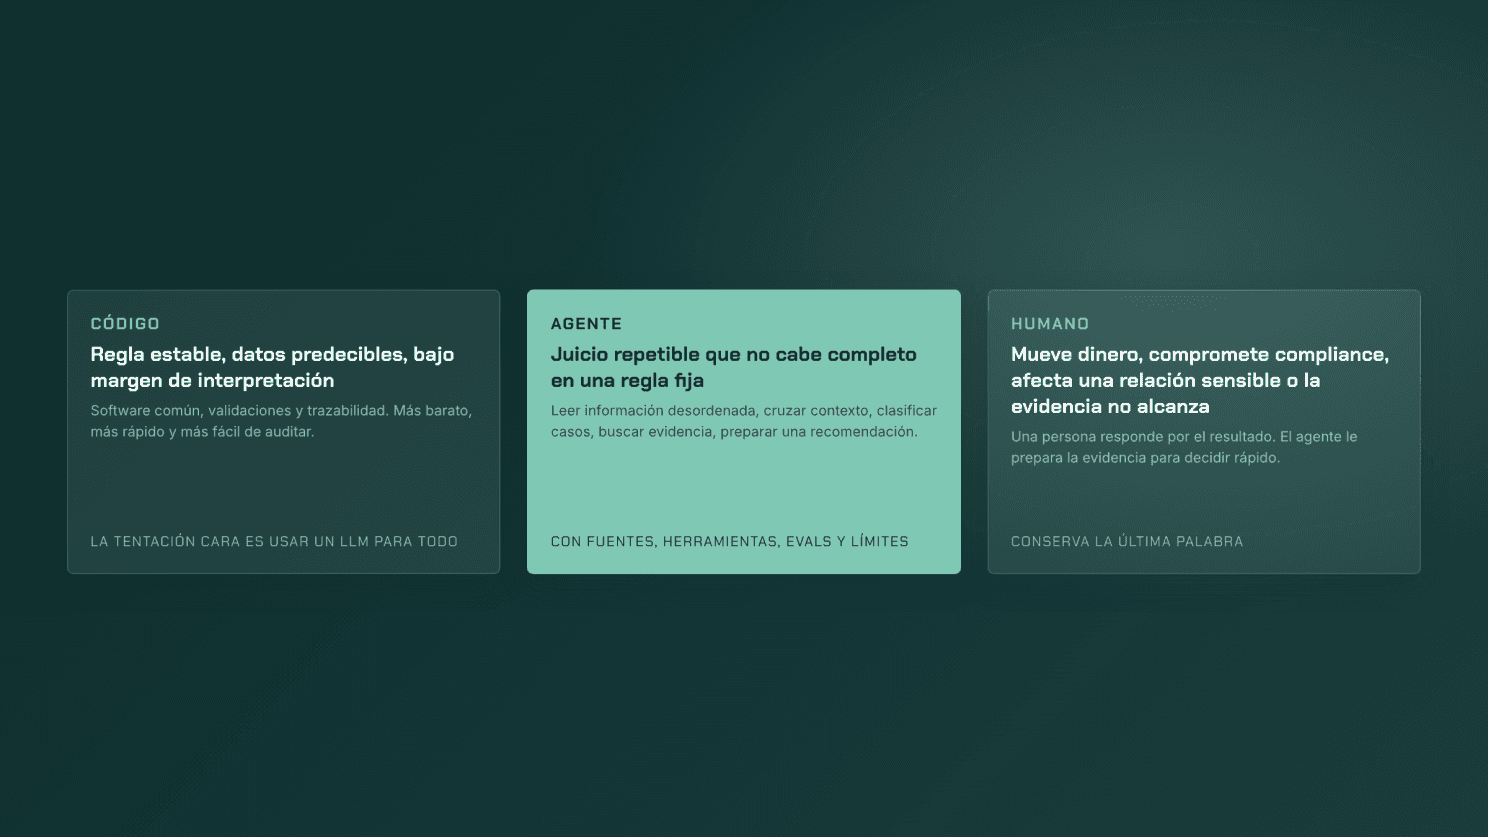
Código, agente y humano.
En STX Agents seguimos una progresión deliberada: primero leer, después preparar, luego recomendar y más tarde ejecutar acciones acotadas con aprobación.
La autonomía aparece después de casos reales, permisos, evals y un mecanismo claro para frenar cuando algo no cierra.
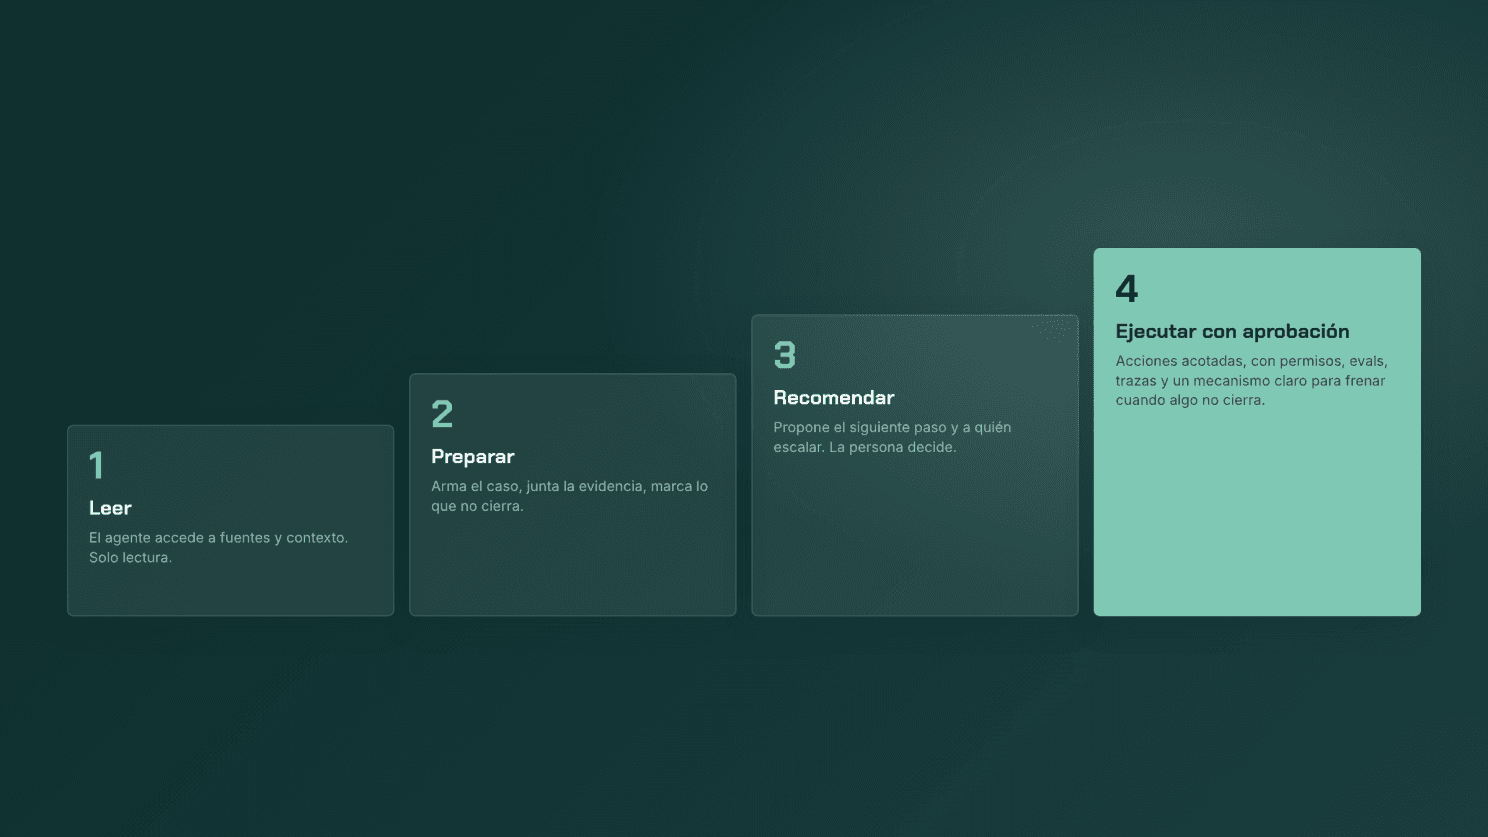
La autonomía aparece después, no antes.
Anthropic recomienda la misma disciplina técnica: empezar por la solución más simple, usar workflows predecibles cuando la tarea está bien definida y sumar comportamiento más autónomo solo cuando la flexibilidad justifica el costo y la latencia.
3. La oportunidad está en el vacío entre sistemas
Muchas iniciativas de IA arrancan con una promesa absurda: “reemplazamos tu CRM” o “reconstruimos todo tu stack”.
En una empresa real, el CRM, ERP o ticketing ya contienen reglas, historia, permisos y procesos que costó años estabilizar. Tirarlos para poner un chat encima suele ser una forma cara de agregar riesgo.
La oportunidad está en construir una capa de acción sobre esos sistemas.
Esa capa puede leer contexto de distintas fuentes, detectar una excepción, preparar un brief, proponer un siguiente paso, derivar una tarea y dejar evidencia de qué hizo. Los systems of record siguen registrando la operación; el sistema de acción ayuda a moverla.
STX Agents se apoya en esa lógica: agentes especializados que trabajan sobre fuentes, herramientas y límites definidos. Cuando una recomendación puede cambiar una decisión sensible, el humano conserva la última palabra.
4. La calidad se diseña y se mide
El problema de los agentes no es solo que puedan alucinar. También pueden usar una fuente equivocada, interpretar mal una excepción, llamar una herramienta que devuelve datos incompletos o producir una respuesta técnicamente correcta pero inútil para quien debe actuar.
Por eso una evaluación útil no pregunta únicamente “¿el modelo respondió bien?”. Pregunta:
¿Encontró la evidencia correcta?
¿Marcó las incertidumbres?
¿Respetó el formato que necesita el operador?
¿Escaló el caso cuando correspondía?
¿Qué corrigió el humano y por qué?
¿Qué costo y latencia tuvo cada corrida?
Cada corrección humana debería alimentar una taxonomía de fallas. Una fuente que viene incompleta, una regla de negocio ambigua o una herramienta que falla son categorías de diseño que hay que resolver, aunque la primera vez parezcan anécdotas.
Un agente sin trazas ni evals es una caja negra con una interfaz simpática. Puede impresionar, pero no merece operar un proceso crítico.
5. La medición empieza antes de construir
La línea de base y una hipótesis verificable tienen que existir antes de abrir un piloto.
Antes del build, elegí una métrica que le importe al dueño del proceso:
tiempo de resolución;
volumen de casos que esperan;
errores o re-trabajo;
riesgo detectado antes;
conversión o velocidad de una oportunidad;
horas de un experto recuperadas para trabajo de mayor valor.
Después definí qué resultado mataría la idea. Si el agente no reduce una cola, no mejora la calidad o no logra adopción después de una ventana razonable, hay que corregir el workflow o dejar de invertir, porque seguir agregando prompts no convierte una hipótesis floja en un producto.
Gartner proyectó que más del 40% de los proyectos de agentic AI se cancelarán antes de terminar 2027 por costos crecientes, valor de negocio poco claro o controles de riesgo insuficientes. Es una predicción, no una ley de la física. Pero describe muy bien la combinación que vemos en los proyectos que nacen desde el hype: autonomía inflada, casos de uso mal elegidos y cero dueño del outcome.
El experto cambia de trabajo
La IA aplicada más útil aparta del loop el trabajo repetitivo que consume atención y deja al experto frente a las excepciones, la calidad y las decisiones donde agrega criterio.
Ese cambio de rol también cambia la conversación comercial, porque la confianza aparece cuando la empresa puede ver qué información usó el sistema, qué permiso tiene, cuándo pidió aprobación, dónde falló, qué aprendió y qué métrica operativa mejoró.
El producto real incluye modelo, sí. Pero incluye también fuentes confiables, herramientas bien diseñadas, permisos, interfaz de trabajo, logs, evals, feedback humano y una operación que se hace cargo de mejorar el sistema con el tiempo.
Lo que haría antes de aprobar el próximo piloto de IA
Pediría cinco respuestas concretas:
¿Qué decisión o resultado operativo queremos mejorar?
¿Dónde se pierde tiempo entre equipos, sistemas y excepciones?
¿Qué parte debe resolver código, qué parte necesita juicio y qué parte sigue siendo responsabilidad humana?
¿Qué evidencia necesita el humano para confiar y actuar rápido?
¿Qué número, dentro de 30 días, demostraría que vale la pena seguir?
Sin esas cinco respuestas, lo que la empresa tiene es una demo buscando un problema, y conviene volver al mapa del workflow antes de gastar en licencias, prompts o agentes nuevos.
Compartir en: